[DocRes] 直接回归像素能学会去畸变吗?
三轮实验,和一个从观察得到的直觉
动机#
阅读 DocRes 的实现,可以发现:同样是 Restormer,去阴影、去模糊等任务直接输出修复后的图像,Dewarping 却输出一张变形图,再从原图中采样颜色。
当然,去畸变使用坐标映射很常见。但既然模型已经能输出图像,原作者团队为什么没有选择让它直接输出展开后的文档?
不急,先观察代码中 Restormer 结构,尤其是 MDTA 模块的定义:
Restormer 的 MDTA 在通道维度计算注意力。把空间位置展平后,核心计算可以简化为下面几行,省略了多头划分和投影:
# q、k、v 的形状均为 [C, H * W]
q = normalize(q, dim=-1)
k = normalize(k, dim=-1)
attention = softmax((q @ k.T) * temperature, dim=-1)  # [C, C]
output = attention @ v # [C, H * W]看完后,我直觉上形成了一种猜测:
MDTA 的转置注意力能根据整幅图像的信息调整各个位置的特征。不过,注意力矩阵并没有直接描述“输出位置 p 应该去输入位置 q 读取什么”,并且一旦得到注意力矩阵,所有的像素将全部按照同一方式混合通道。
这就导致转置卷积擅长的是全局理解,以及将这种理解与自身 token 邻域结合来回归输出。更进一步,我认为这种全局信息的插入是低频且连续的,意味着某一局部邻域内的 token 所接受到的全局信息是相似的。
由此就可以解释作者选择背后的原因:
- 回归位移图需要的能力是全局理解,但通常是位移图是平滑且连续的,尤其是原实现中的偏移图,甚至是很平坦的。
- 直接回归像素则需要考验跨区域长程像素重建,且精度要求高,高频细节多。更重要的是,这些高频信息不来自于 token 自身的邻域。这是 MDTA 所不擅长的。
即便是加入了 GDFN,也只能随着层数缓慢聚合邻域内的高频信息,且随着层数加深,表示愈发抽象,远处的高频细节将难以被目标位置的 token 读取。
简而言之:理解整张图的情况,与把远处一个字的细笔画精确搬过来,所需要的能力不同。 Restormer 的架构设计决定了它更适合前者。Restormer 原文 §3.1 ↗
X-Restormer 也提出了类似的观点。它指出,Restormer 虽然能利用大范围甚至全局信息,但细纹理重建和空间映射能力仍有相对不足,因此它加入空间注意力增强空间交互。它主要研究超分等图像恢复任务,虽然和本文主题不直接相关,但提供的 insight 有参考意义。X-Restormer 原文 §4 ↗
于是,我准备用实验验证我的假设:权重使用作者训练好的 DocRes,保持网络结构,但让 dewarp 从预测坐标残差,改为直接回归展开后的像素颜色。
TL;DR:三轮实验之后,损失明显下降,但实际效果不理想(如文字模糊)。未能得到满意的直接像素去畸变模型,但证据支持先前的猜测。
实验设置#
准备数据#
原方案:
输入图像 + prompt → Restormer → 坐标残差
→ 加回基础坐标 → 平滑、上采样 → 从原图采样颜色新的标签对直接回归颜色:
输入图像 + prompt → Restormer → 展开后的三通道颜色Doc3D 数据集提供了变形图像和真实 backward map。实验所需的新 Ground Truth 只需用真实 backward map 从原图采样即可构造。
新的目标保留了输入中的光照、阴影和原有清晰度,只训练几何展开。如此可避免模型同时学习其他任务、引入干扰。
实验计划#
计划将实验分为两部分:短训和长训。
由于训练目标出现极大改变,因此引入几轮预实验(短训),将数据集设置得非常小,故意让模型过拟合,以评估训练难度、成本和效果,并调整超参数。
之后,从过拟合的模型权重出发,进行全量数据集长训,提升精度与泛化能力。
不过,以上只是计划。计划是赶不上变化的。
事实是,在短训中,我们的方法就遭遇了严重阻碍,模型甚至出现了类似欠拟合的迹象,表明实验没有太大必要继续进行了。
这就是说,没有长训了。
过拟合短训#
我从 Doc3D 数据集下载了第 8 组的 img / bm / uv 三个包,共配对出 2066 份样本,再固定种子抽取 16 张作为短训过拟合数据集,后续三轮实验都只用了这 16 张。
鉴于短训的目的,这次没有独立验证集或测试集。后面所有 stats 都只是训练集上的拟合诊断,因此看不出模型的泛化能力。
分辨率 vs 算力#
算力采用了 A100 PCIe 40 GB,数据选择了 512×512 整页(从 448×448 放大而来)、BF16、batch size=2,不使用 activation checkpointing.模型参数和 AdamW 状态仍为 FP32,全部参数参与微调。没有数据增强。
这里的 512 是整页 resize,不是随机裁剪 patch。这是因为,去畸变需要把不同位置的内容对应起来,随意裁掉一角可能删除必要的源像素。
在实际训练之前,使用了一个资源探针脚本测试算力需求:
| 尺寸 | 精度 | 逐 block 重算 | step 中位数 | CUDA peak allocated | CUDA peak reserved |
|---|---|---|---|---|---|
| 256×256 | FP32 | 否 | 0.224 s | 7.78 GiB | 7.94 GiB |
| 512×512 | FP32 | 否 | 0.787 s | 30.41 GiB | 31.16 GiB |
| 512×512 | BF16 | 否 | 0.369 s | 15.42 GiB | 15.84 GiB |
| 512×512 | BF16 | 是 | 0.444 s | 2.62 GiB | 3.06 GiB |
| 1024×1024 | BF16 | 是 | 1.716 s | 9.88 GiB | 11.81 GiB |
结果表明 1024 加重算也能运行,但单步更慢。权衡了吞吐和页面信息后,最终选择了 512.真实训练的稳定更新约 0.71s 一步,peak allocated 约 30.8 GiB.
每步处理两张图,500 步就是 1,000 次样本暴露,相当于把 16 张图看了 62.5 遍。如果模型能力足够且学习率合适,这个数量理应造成过拟合。
Round 1#
第一轮从原 DocRes 权重开始,学习率 1e-5 跑 500 步,并在 32、64 步时设置断点评估效果。训练中用 SwanLab 记录标量和预览。
有效区域 L1 从初始的 0.4465,降到 64 步的 0.1642,500 步时为 0.0781。同一目标和有效区域下,原位置输出输入图的 L1 约为 0.3045,输出全白约为 0.5442。模型显然学到了东西。
但图片看起来没有数值说的那么令人满意。
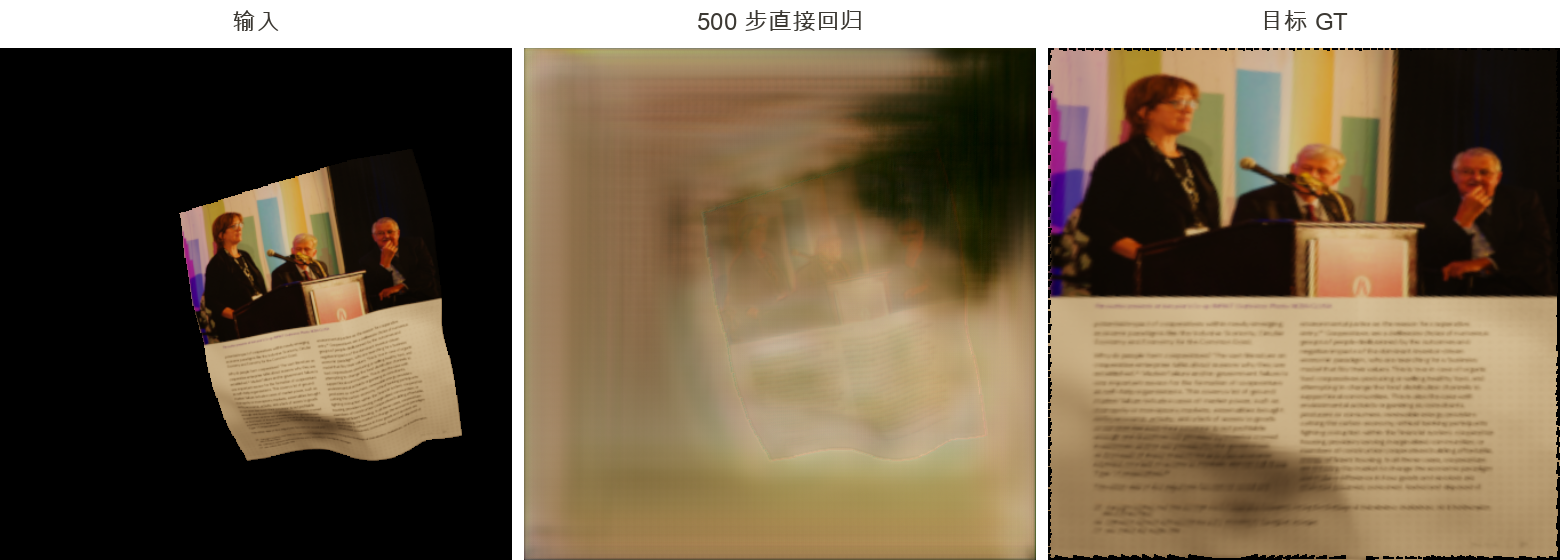
这是四张固定预览中的照片页。预测残余了输入页面的歪斜轮廓,同时铺开一片接近目标颜色的背景。图片可点击放大。
文字没有清楚地移动到目标位置,原页面的轮廓仍在,周围还有残影。预期的展开效果几乎没有。
我意识到,隐式约束模型“搬像素”的困难性。毕竟,颜色相近的背景在文档中有一大片,我们的训练目标真的能让模型学会点对点的搬运吗?目前的状态更像是模型学到了如何识别一个文档的背景色调,然后输出一个该色调的纯色背景。这招投机取巧目前无法被我们的损失指标所遏制。
这时直接开始数小时长训,或者反过来宣布“果然是架构不行”,均不合适。现在考虑改进方法,再短训一轮。
Round 2#
第二轮安排了三个训练组,以及一个现有的 baseline 推理参考。
| 组别 | 做什么 | 想检查什么 |
|---|---|---|
| A | 原权重开始,原位置恒等重建,500 步 | 当前设置能否让模型忘记原来的任务目标(backward map),将输出空间对齐到颜色空间? |
| B | 从首轮完整状态续到总计 2000 步,lr=1e-5 | 是不是之前训练太短? |
| C | 从原权重重新开始,2,000 步,lr=3e-5 | 之前的学习率是不是太低? |
| D | 权重复制原版 DocRes,只做推理 | 原版 DocRes 在这批图上表现怎样? |
实验结果表明,原位置恢复文字可行。
A 的结果#
A 在 500 步时的 L1 降到 0.00984,页内文字基本恢复,仍有轻微模糊。
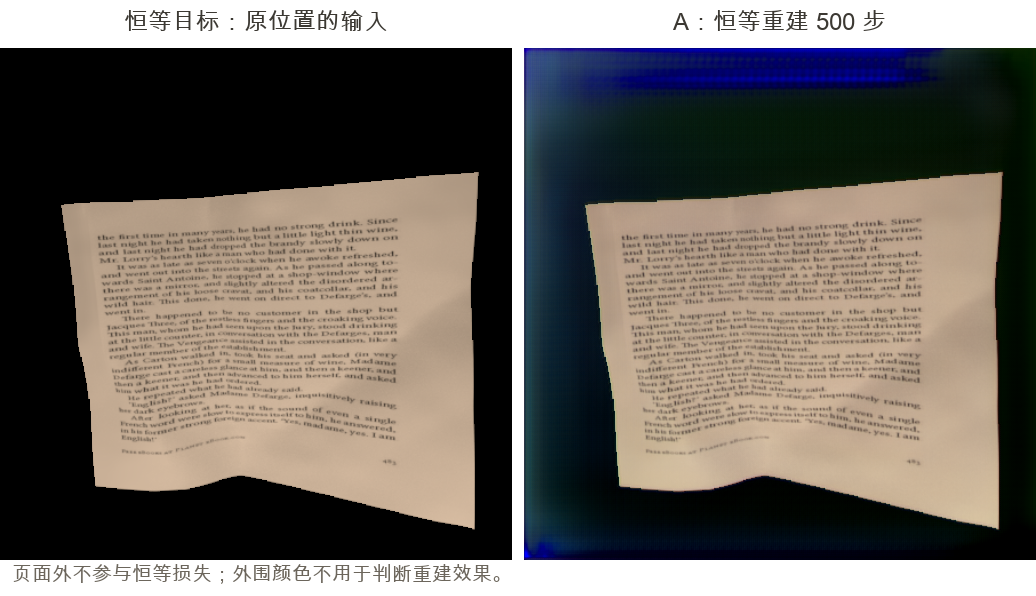
这个结果至少说明,当前训练设置并非不能恢复高频细节,只是在以展开图像为目标训练时遇到问题。
关键可能在于高频和长程两个难点的组合,以及训练约束的缺乏导致模型难以学到如何远程提取。
当然,这也已经能够部分支持:Restormer 的 Inductive Bias 可能不适合这种长程高频信息的 Grounding 和 Fetching.
B 和 C#
B 延长到 2000 步,L1 降到 0.04111;C 提高学习率后,同为 2000 步,进一步降到 0.03275。
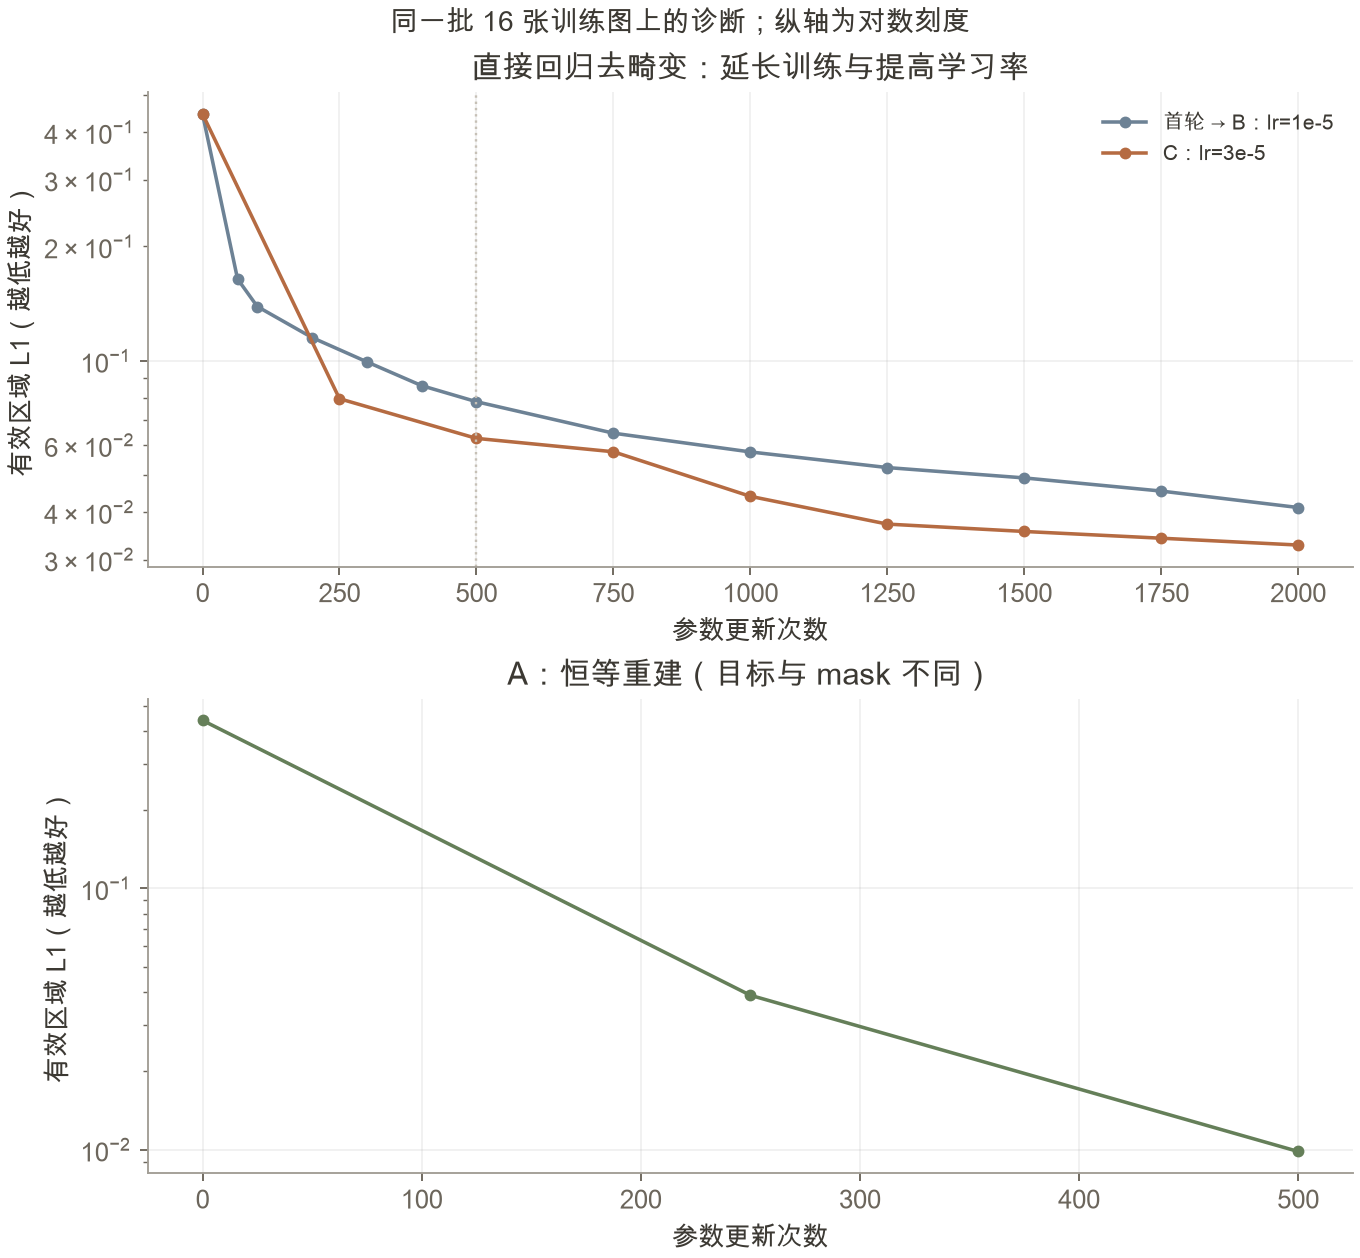
无论是 B 还是 C,相比第一轮均有明显改善,说明训练预算和学习率确实影响结果,或许第一轮对架构能力的估计有些过于悲观。
但即便损失继续下降,预测效果也没有变得很好。
| 配置 | 去畸变更新 | 全图 L1 ↓ | 固定文字框 L1 ↓ | PSNR ↑ |
|---|---|---|---|---|
| 首轮 | 500 | 0.07806 | 0.06339 | 18.04 dB |
| B | 2,000 | 0.04111 | 0.04139 | 22.68 dB |
| C | 2,000 | 0.03275 | 0.03830 | 24.61 dB |
| D:预训练坐标参考 | 无新增训练 | 0.03438 | 0.03762 | 22.58 dB |
全图指有效输出区域。文字框固定在四张预览页,每页两框;首轮的文字框与 PSNR 来自第二轮统一重评。PSNR 先将预测限制到 [0,1],对逐图等权的 MSE 取平均后计算;L1 使用未截断的浮点预测。
C 的全图 L1 和 PSNR 已经优于 D(因为 C 仅拟合 16 张图),但细节效果仍远不及 D.
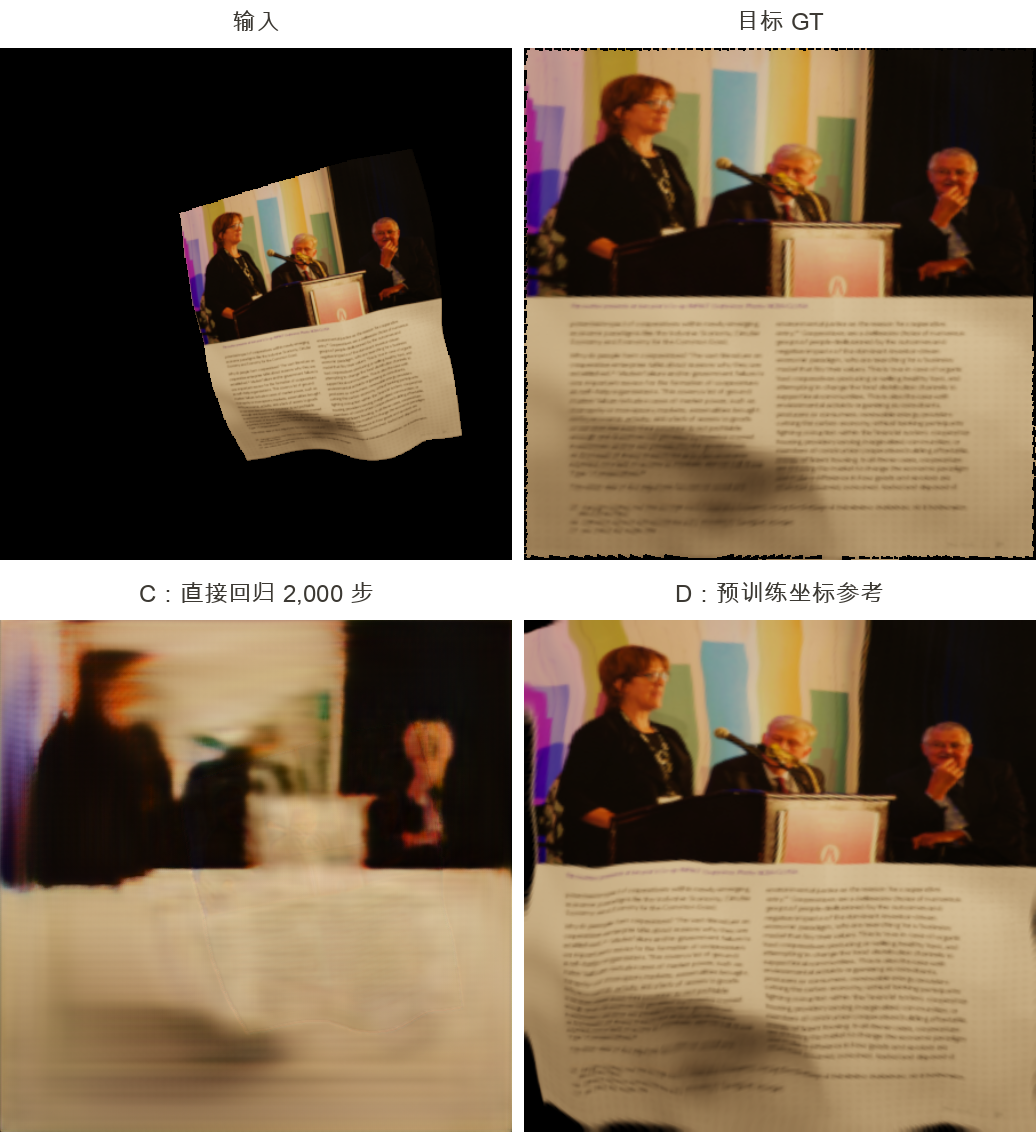
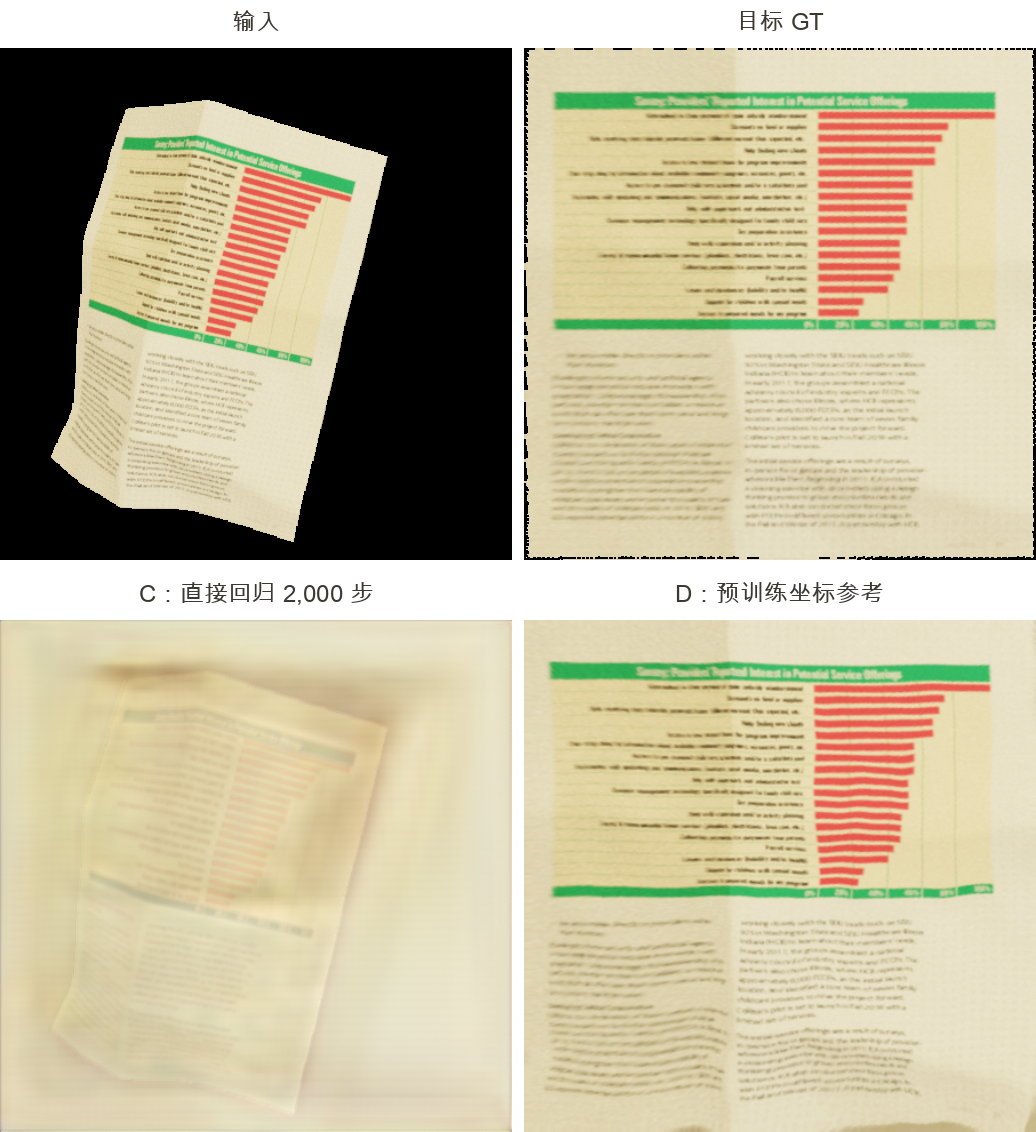
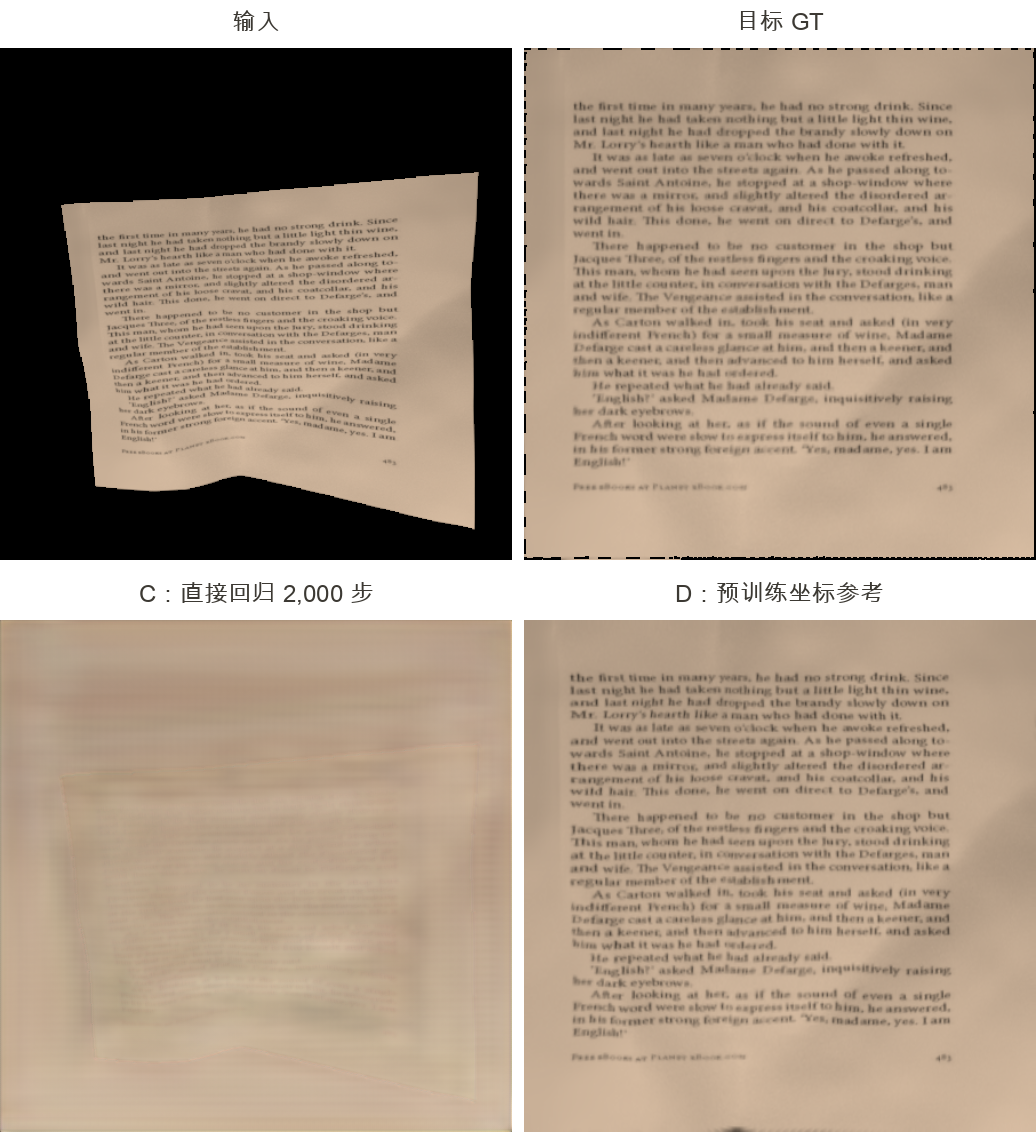
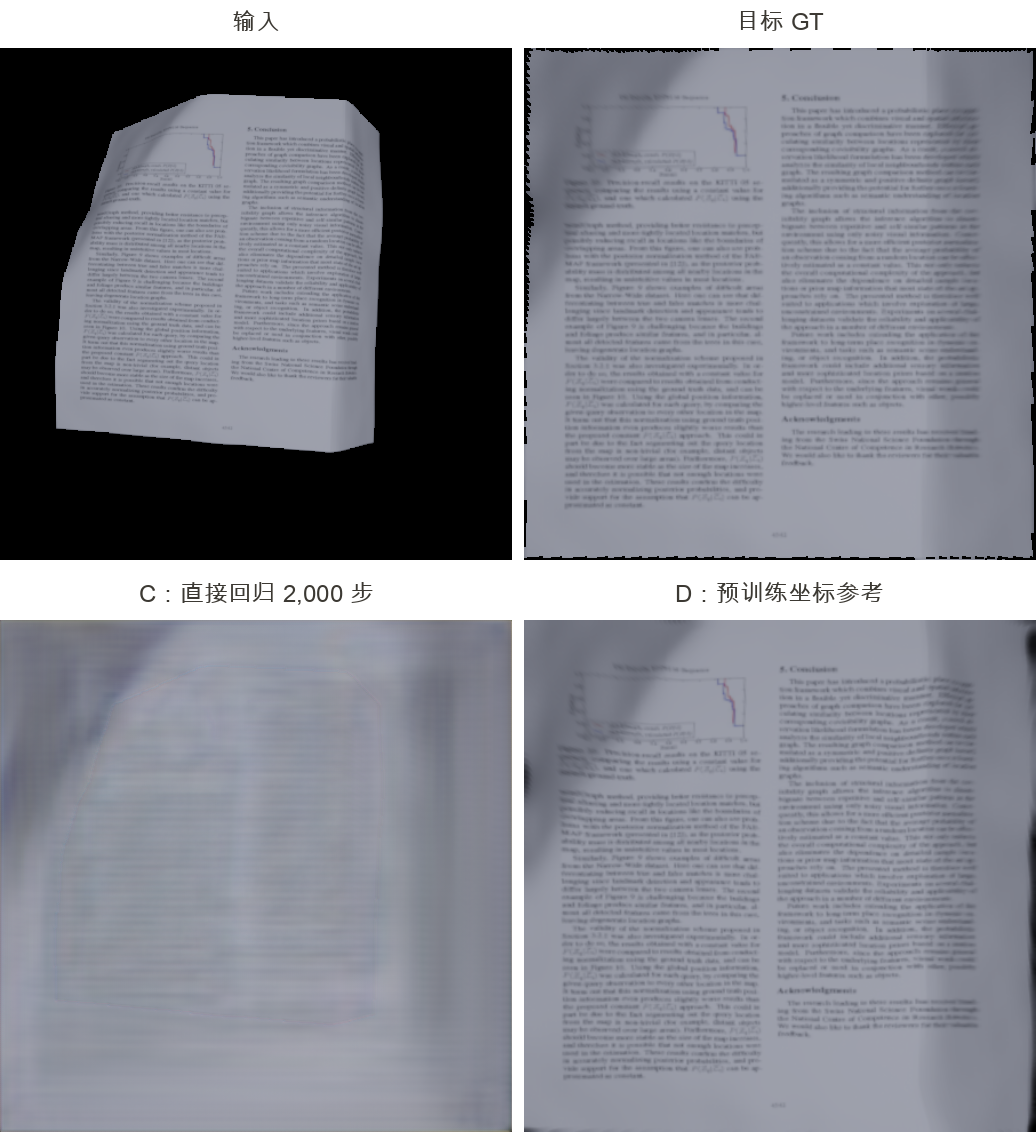
以上保留了全部四张固定预览。D 也有局部弯曲和几何误差。
也可以放大看看:
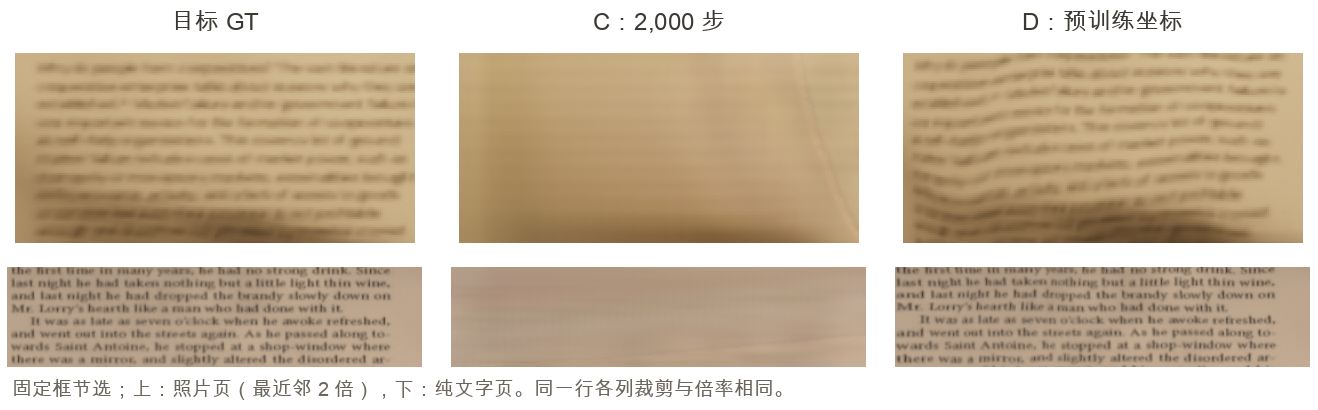
从既有八个固定框中节选两框,各列使用相同 GT 坐标裁剪,没有锐化。完整八框见仓库图表。
这个现象十分有趣。C 预测的照片和低频颜色布局逐渐接近目标,不过细字部分仍只是模糊的行状纹理。
这生动地诠释了指标和实际效果之间的差别:很多时候 L1/PSNR 反映的任务性能未必真实。
Round 3#
不甘心就这样结束捏。。。所以就有了第三轮。
看到 A 的文字基本恢复后,我萌生了希望(这不就是胡萝卜和驴的故事嘛):或许先前直接训练性能不够好,是因为模型的输出空间还停留在 backward map 语义,没有转到颜色空间来;现在 A 已经成功将输出语义对齐到颜色了,基于它再训练是否性能会更好?
第三轮就从 A 的 500 步权重开始,目标重新回到一开始的直接去畸变,学习率用 C 的 3e-5。
初始输出的确保留了输入的文字。但切换目标之后,细字又逐渐模糊,原页面轮廓和残影仍然存在。
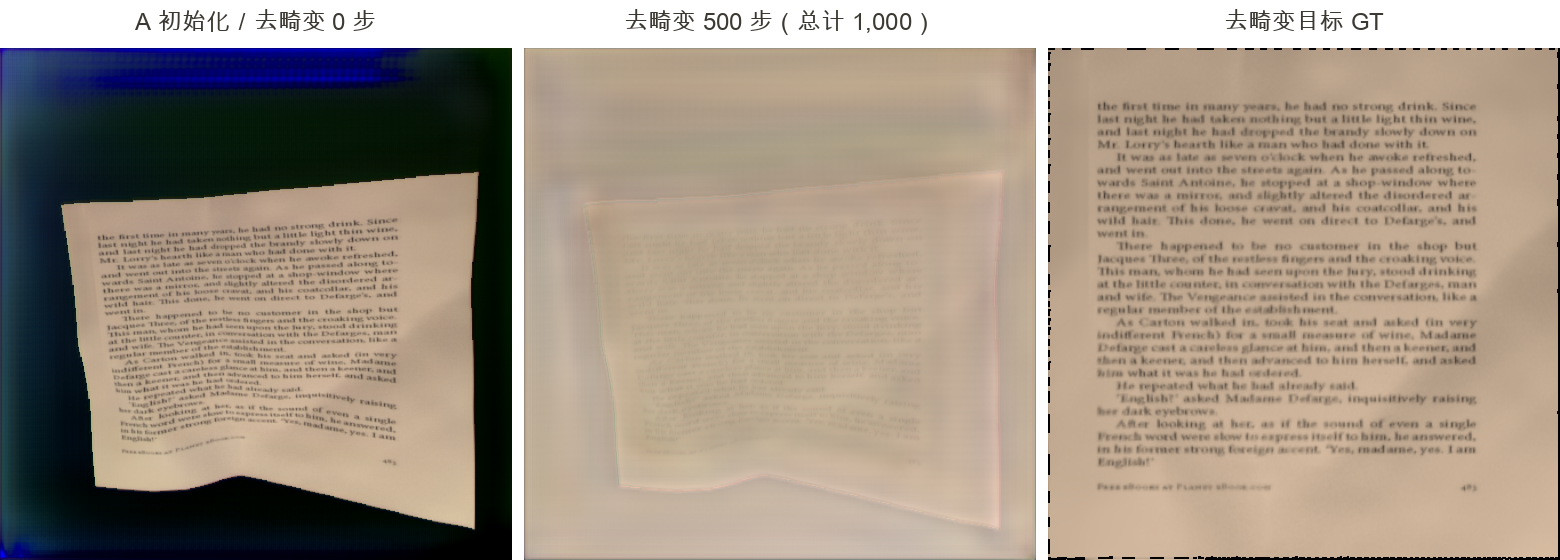
第三轮训练了 500 步时,L1 为 0.05149,优于 C 同样去畸变 500 步的 0.06251。乍看之下,先做恒等重建似乎有用。
但如果算上 A 的 500 步,那么还是不如 C:
| 配置 | 去畸变更新 | 总更新(含恒等重建) | 全图 L1 ↓ |
|---|---|---|---|
| 第三轮:A 初始化 | 500 | 1,000 | 0.05149 |
| C:原权重初始化 | 500 | 500 | 0.06251 |
| C:原权重初始化 | 1,000 | 1,000 | 0.04400 |
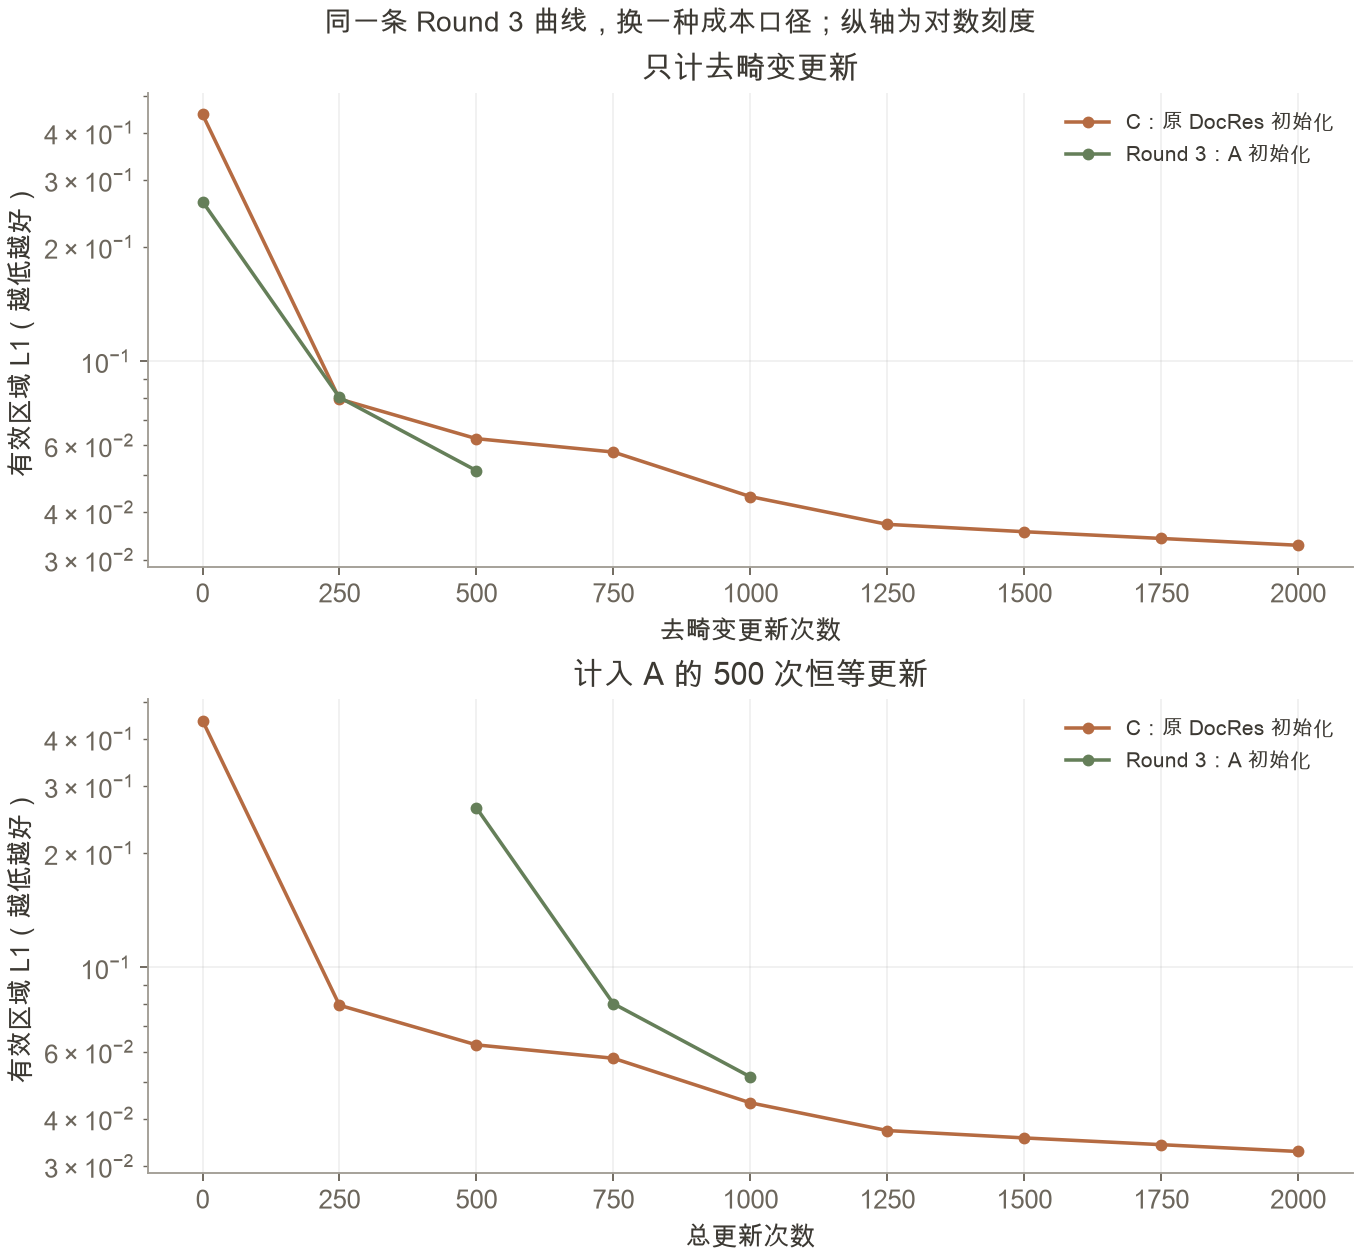
我的判断:第三轮“恒等初始化”的方法相比 C 的方法,没有明显更好地解决文字和几何质量的问题,且总体训练预算也没有降低。
第三轮最终停在 500 步,没有继续追加训练。
蓦然回首#
做完实验之后,我仍然觉得,几何纠正中“知道去哪里取内容”与“重新生成那里的颜色”,值得分开考虑。
原版坐标方案把精细颜色的搬运交给模型权重之外的采样算子,这种约束确实是更好的做法,并且也不全归因于 Restormer 架构的限制——这种做法在训练时目标会更加明确,帮助网络更好地理解任务。
它还有一个实际优势:网络可以在较低分辨率预测几何,再从原生图中取颜色。本次原图只有 448×448,但面对更高清的文档,这种计算与细节来源的分离显得更加重要。直接颜色输出要么面临下采样的细节丢失,要么须付出更多计算成本。
这使我更理解 DocRes 选择坐标路线的合理性,赞叹于这个集多重优势于一体的自然的想法。但“我能解释这个选择很好”,不等于“作者当时为什么这样选择”。DocRes 原文 ↗ 并没有为我最初那条架构猜测提供直接答案。
这次比较明确的收获有三点:
- 在所用的 16 张图、初始化、分辨率、L1 损失和最多 2000 步预算下,直接颜色回归可以降损,但没有得到满意的文字保真与几何展开。
- 恒等重建成功、延长训练和提高学习率有效,提醒我不能跳过优化与任务适应的检查,直接把首轮现象归因于架构。
- 全图像素指标与文档可读性存在明显距离;训练策略的收益,也需要把前置成本计入后再看。
至于“Restormer 是否不擅长长程高精度搬移”,它仍然是一个待验证的解释。这里没有改变搬移距离的受控实验,也没有匹配预算的结构对照、多种子或收敛性检验。把一个复杂的真实去畸变任务做不好,原因有很多而无法一一排除。
如果继续,我更想把问题缩小:给模型固定的、已知距离的平移,使用训练时没见过的文字或随机纹理,比较恒等、短距离和长距离搬移,再加入坐标采样或更强空间交互的对照。这样才更容易问清楚,困难究竟随什么变化。
这次就先停在这里。最初想用一个小实验验证结构直觉,最后留下的结论比预想更窄。但我至少开始学着区分:哪些东西只是听起来合理,哪些确实被眼前的结果支持,以及下一笔算力应该花在哪个问题上。
代码、材料与说明#
实验仓库 ↗对应目录为 experiments/dewarp_direct_pixel_regression/,代码和说明文档大体是按照三轮实验组织的。前文所述的完整八个文字框保留在 artifacts/figures/。
此处给出 终点指标 CSV 和 绘图与评价报告 的下载链接,包含各轮诊断点、第三轮预算比较和固定裁剪框。
本次的起始问题和结构直觉由我提出,博文由我撰写。特别感谢 ChatGPT ↗ 在对照方案讨论、代码实现、材料整理、文字润色方面的帮助。
结尾难绷#
顺便记录 吐槽 一下这次 remote 开发的几项额外心得 遭遇 :
- PyCharm Deployment:挺好用一功能,但是一些细节比较难受,比如首次上传要手动同步、Remote Run 要单独设置 server interpreter、Excluded Paths 的设置界面有卡死 bug ↗ 等等;
- SwanLab:它和 TensorBoard 对
protobuf的版本要求撞车,最后调整好几种版本组合才跑通(但凡跑过这种依赖关系庞杂的项目,都不会想轻易调整某个库的版本的,因为这是一个 CSP 问题)这边建议考虑一下uv; - 矩池云:这家时租标价低,但其实暗藏玄机——他们家不能无卡开机!!!装环境、同步文件、下载数据的时间都给你照原价收钱;
- 环境快照:还是矩池云,他家关机就会清数据,想保存实例快照得要额外购买存储空间;
得,就这样吧。