Restormer
把注意力转到 channel 维度:Restormer 如何处理高分辨率图像修复
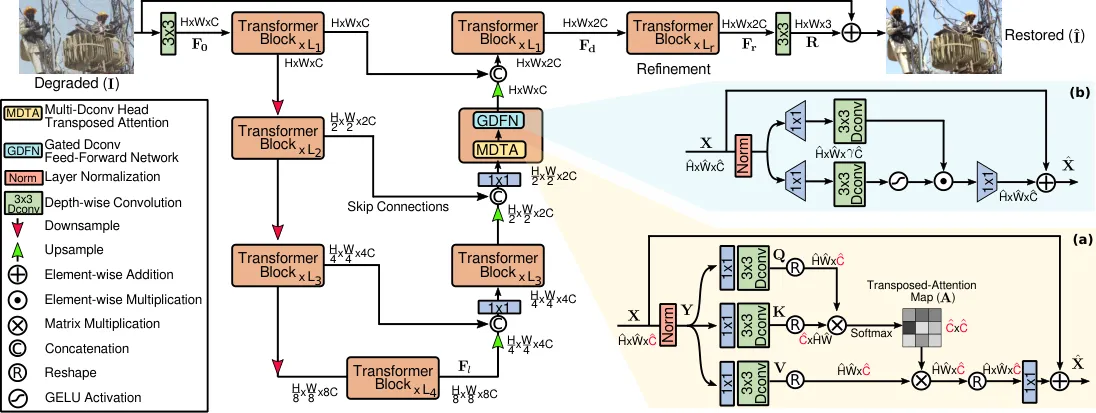
From Restormer: Efficient Transformer for High-Resolution Image Restoration ↗. 封面为原论文 Figure 2,保留原图。实现可见 Restormer 仓库 ↗。
Restormer 的任务是图像修复,比如去噪、去雨、去模糊。和图像理解或者分类不同,这类任务需要保留大量空间细节,最后还要输出高分辨率图像。
此时若直接对每个像素做经典 self-attention,像素之间两两计算相似度,复杂度会爆炸;若通过较大的 patch 或局部窗口压低计算量,又需要考虑细节保留和长程信息交换的问题。
Restormer 的核心改动是:保留稠密的空间特征,但把 attention map 从像素之间的关系,转成 channel 之间的关系。 再配合 Depthwise Convolution,让局部信息也参与进来。
整体架构#
整体是一个四层的 encoder-decoder,和 U-Net 的思路相近:encoder 逐级降低空间分辨率、增加 channels,decoder 再恢复分辨率,并通过 skip connections 接回浅层特征。最后还有一个在高分辨率下工作的 refinement 阶段。
不过,每个阶段的核心组件换成了 Transformer Block,其中主要是两个模块:
- MDTA:Multi-Dconv Head Transposed Attention.
- GDFN:Gated-Dconv Feed-Forward Network.
MDTA:把注意力转过来#
先用 卷积混合 channels,再用 depthwise convolution 混合每个 channel 内的邻域信息,生成 。
设空间位置数为 ,每个 head 的通道数为 。如果沿用常见的 [B, head, N, d] 布局,经典 attention 计算的是:
而 Restormer 将最后两个维度转置,改用 [B, head, d, N],此时相同形式的点乘得到:
也就是说,原来是比较两个位置的特征,现在是比较两个 channel 在整张 feature map 上的响应。
固定 head 数量和通道数时,注意力矩阵乘法的计算量从 变为 ,对像素数量只呈线性增长。 这里比较的是每个 head 的 attention 部分,不是整个网络的全部开销。
原实现的核心过程可以写成:
# q, k, v: [B, head, d, N]
q = torch.nn.functional.normalize(q, dim=-1)
k = torch.nn.functional.normalize(k, dim=-1)

attn = (q @ k.transpose(-2, -1)) * temperature
attn = attn.softmax(dim=-1)  # [B, head, d, d]
out = attn @ v # [B, head, d, N]其中 q 和 k 沿空间维做 L2 归一化,因此点积相当于比较两个 channel 的空间响应的余弦相似度。每个 head 还有一个可学习的 temperature,用来调节 softmax 前分数的尺度,也就调节了注意力分布的尖锐程度。
这里需要区分两件事:
- 通道关系由整张 feature map 共同决定,因此 attention map 含有全局信息。
attn @ v在每个位置混合 channels,并没有直接让该位置对所有远处位置的 value 加权求和。直接的邻域空间混合由 depthwise convolution 等操作承担。
我的理解是,MDTA 让全局信息参与决定「每个位置应该怎样混合特征」,同时避免显式构造一个巨大的像素关系矩阵。它和经典空间 attention 的信息传递方式确实不同。
GDFN:带门控的 FFN#
普通 FFN 对每个位置独立做通道变换。GDFN 则分出两条分支,两条都经过线性投影和 depthwise convolution,其中一条再经过 GELU,最后逐元素相乘、投影回原通道数。
忽略残差连接,可以简写为:
其中 表示 卷积, 表示 depthwise convolution。
这种「两路变换,再用一条路门控另一条路」的思路,与 LLaMA 中的 SwiGLU 有相似之处。不过 GDFN 使用的是 GELU,还引入了空间卷积,不能直接当成同一个模块。
一些想法#
我觉得 Restormer 很有意思的一点是,它没有执着于保留经典 self-attention 的计算方式。图像修复既需要细节,也需要大范围的上下文,但不一定非要通过一个 的 attention map 来实现。
Depthwise convolution 提供局部空间混合,通道注意力提供随输入变化的全局条件,再加上多尺度 encoder-decoder,让计算量和修复需求之间有了一个不错的折中。
这也让我想到 DocRes:当任务涉及文档去扭曲时,直接输出采样坐标,和直接输出修复后的像素,是两种不同的建模选择。MDTA 的信息传递方式可以作为理解这种选择的一个角度,不过不能仅凭模块结构,就断言模型一定无法学习长程形变。