课程笔记 →
Bellman Equation
文中大量使用 π 表示 policy 策略,因为 π 是希腊字母中与 p 对应的字母。
Evaluating Policy#
Policy 会生成 trajectory,而 trajectory 对应一个 return. 因此可以通过 return 评估一个 policy 的好坏。
Policy 和 reward 往往都不是确定性的,因此需要计算 return 的期望。
Calculating Return#
一、定义法#
计算 reward (贴现之后的)加和。
二、自举法(Bootstrapping)#
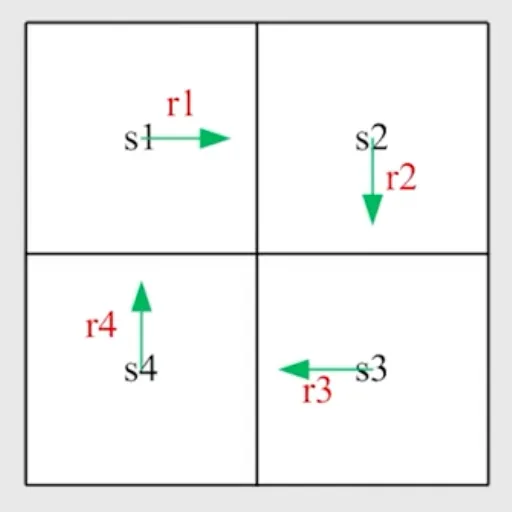
考察这个 policy,发现 agent 会进入循环。
设 vi 为 agent 位于 si 时,未来的 reward 之和(贴现后):∑k=i∞γk−ir(k−1)%4+1
那么可以列出方程组
⎩⎨⎧v1=r1+γv2v2=r2+γv3v3=r3+γv4v4=r4+γv1
这个方程组是一个非齐次线性方程组,有唯一解。
写成矩阵向量形式,即 v=r+γPv.
其中
P=0001100001000010
这就是贝尔曼公式,或者说在这种特殊的确定性情况下的实例。
实际上,P 就是一步可达的状态转移矩阵。
State Value#
考察单步过程
St→AtRt+1,St+1其中:
- t,t+1 表示离散的时间步
- St 表示时刻 t 时的状态
- At 表示 St 处所采取的动作
- Rt+1 表示在采取动作 At 后得到的奖励
- St+1 表示在采取动作 At 后转移到的状态
当然,Rt+1 的下标有时也记成 Rt,数学结构不变。
注意,St,At,Rt+1 均为随机变量,并服从以下分布:
- St→At 服从策略分布 π(At=a∣St=s)
- St,At→Rt+1 服从奖励分布 p(Rt+1=r∣St=s,At=a)
- St,At→St+1 服从状态转移分布 p(St+1=s′∣St=s,At=a)
考察多步过程
St→AtRt+1,St+1→At+1Rt+2,St+2→At+2⋯记 Gt=Rt+1+γRt+2+γ2Rt+3+⋯,其中 γ∈[0,1) 是贴现系数。
则 Gt 也是随机变量。
由上述定义知,Gt 就是一个 trajectory 的 discounted return,而 state value 就是 Gt 的期望值。
state-value function (or simply state value) 定义:
vπ(s)=E[Gt∣St=s]
含义:从某个状态 s 出发,在给定策略 π 下,期望得到的 discounted return. 这个量可以评估状态 s 的“价值”。
确定性的情况下,state value 和 discounted return 是相同的。
在一般的情况下,对于 trajectory 的一个采样,仍然有 Gt=Rt+1+γGt+1
因此,
vπ(s)=E[Gt∣St=s]=E[Rt+1+γGt+1∣St=s]=E[Rt+1∣St=s]+γE[Gt+1∣St=s]
运用全期望公式化简第一项,得:
E[Rt+1∣St=s]=E[E[Rt+1∣St=s,At=a]∣St=s]=a∑π(a∣s)E[Rt+1∣St=s,At=a]=a∑π(a∣s)r∑p(r∣s,a)r
这一项表示,从 s 出发,按照 policy 走一步能得到的奖励的期望。
再处理第二项:
E[Gt+1∣St=s]=E[E[Gt+1∣St+1=s′,St=s]∣St=s]=E[E[Gt+1∣St+1=s′]∣St=s]=E[vπ(s′)∣St=s]=s′∑vπ(s′)a∑p(s′∣s,a)π(a∣s)
这一项表示,从 s 出发,到达的新状态的 state value 的期望。
最终,可整理出:
vπ(s)=a∑π(a∣s)(r∑p(r∣s,a)r+γs′∑p(s′∣s,a)vπ(s′)), s∈S
此即贝尔曼公式。
它刻画了状态空间中,不同状态之间的 state-value function 的关系。
分析一下:
- 等号两侧都有 vπ,意味着这是一个 bootstrap 形式的公式。
对于有限的 S,可以对所有 s 列出贝尔曼公式,形成方程组,然后求解出 vπ(s).
- 贝尔曼公式依赖于 policy π,因此对于给定 policy,求解贝尔曼公式被称为 policy evaluation.
- p(r∣s,a) 和 p(s′∣s,a) 反映了对世界的建模,在此处我们需要它已知。
Bellman Equation#
贝尔曼公式可以写成矩阵-向量形式以便理解和求解。
先定义两个量,对应第一项和第二项:
rπ(s)≜a∑π(a∣s)r∑p(r∣s,a)r
pπ(s′∣s)≜a∑π(a∣s)p(s′∣s,a)
然后,可将贝尔曼公式整理成:
vπ(s)=rπ(s)+γs′∑pπ(s′∣s)vπ(s′)
记 n=∣S∣.
将 pπ(sj∣si) 写成一个 n×n 的矩阵 Pπ,其中 [Pπ]i,j=pπ(sj∣si);
将 vπ(si) 写成列向量 vπ=[vπ(s1),…,vπ(sn)]T∈Rn;
将 rπ(si) 写成列向量 rπ=[rπ(s1),…,rπ(sn)]T∈Rn;
那么原式可化为:
vπ=rπ+γPπvπ
求解贝尔曼公式#
求解贝尔曼公式的过程称为 policy evaluation,是 RL 中的基本问题,是优化 policy 的关键。
闭式解#
根据线性代数理论,可以直接得到 vπ=(I−γPπ)−1rπ.
迭代法#
实践中通常不会使用闭式解求解:求逆在状态空间 n 较大时计算过于复杂。
vk+1=rπ+γPπvk
由不动点理论保证,vk→vπ=(I−γPπ)−1rπ,k→∞.
证明
vk→vπ设 δk=vk−vπ,我们只需证明 δk→0,k→∞.
代入迭代公式,得:
vπ+δk+1=rπ+γPπ(vπ+δk)使用贝尔曼公式的矩阵-向量形式,可消去 vπ 化简,得:
δk+1=γPπδk由于 γ∈[0,1),[Pπ]i,j∈[0,1],且 Pπ1=1,因此 δk→0,k→∞.
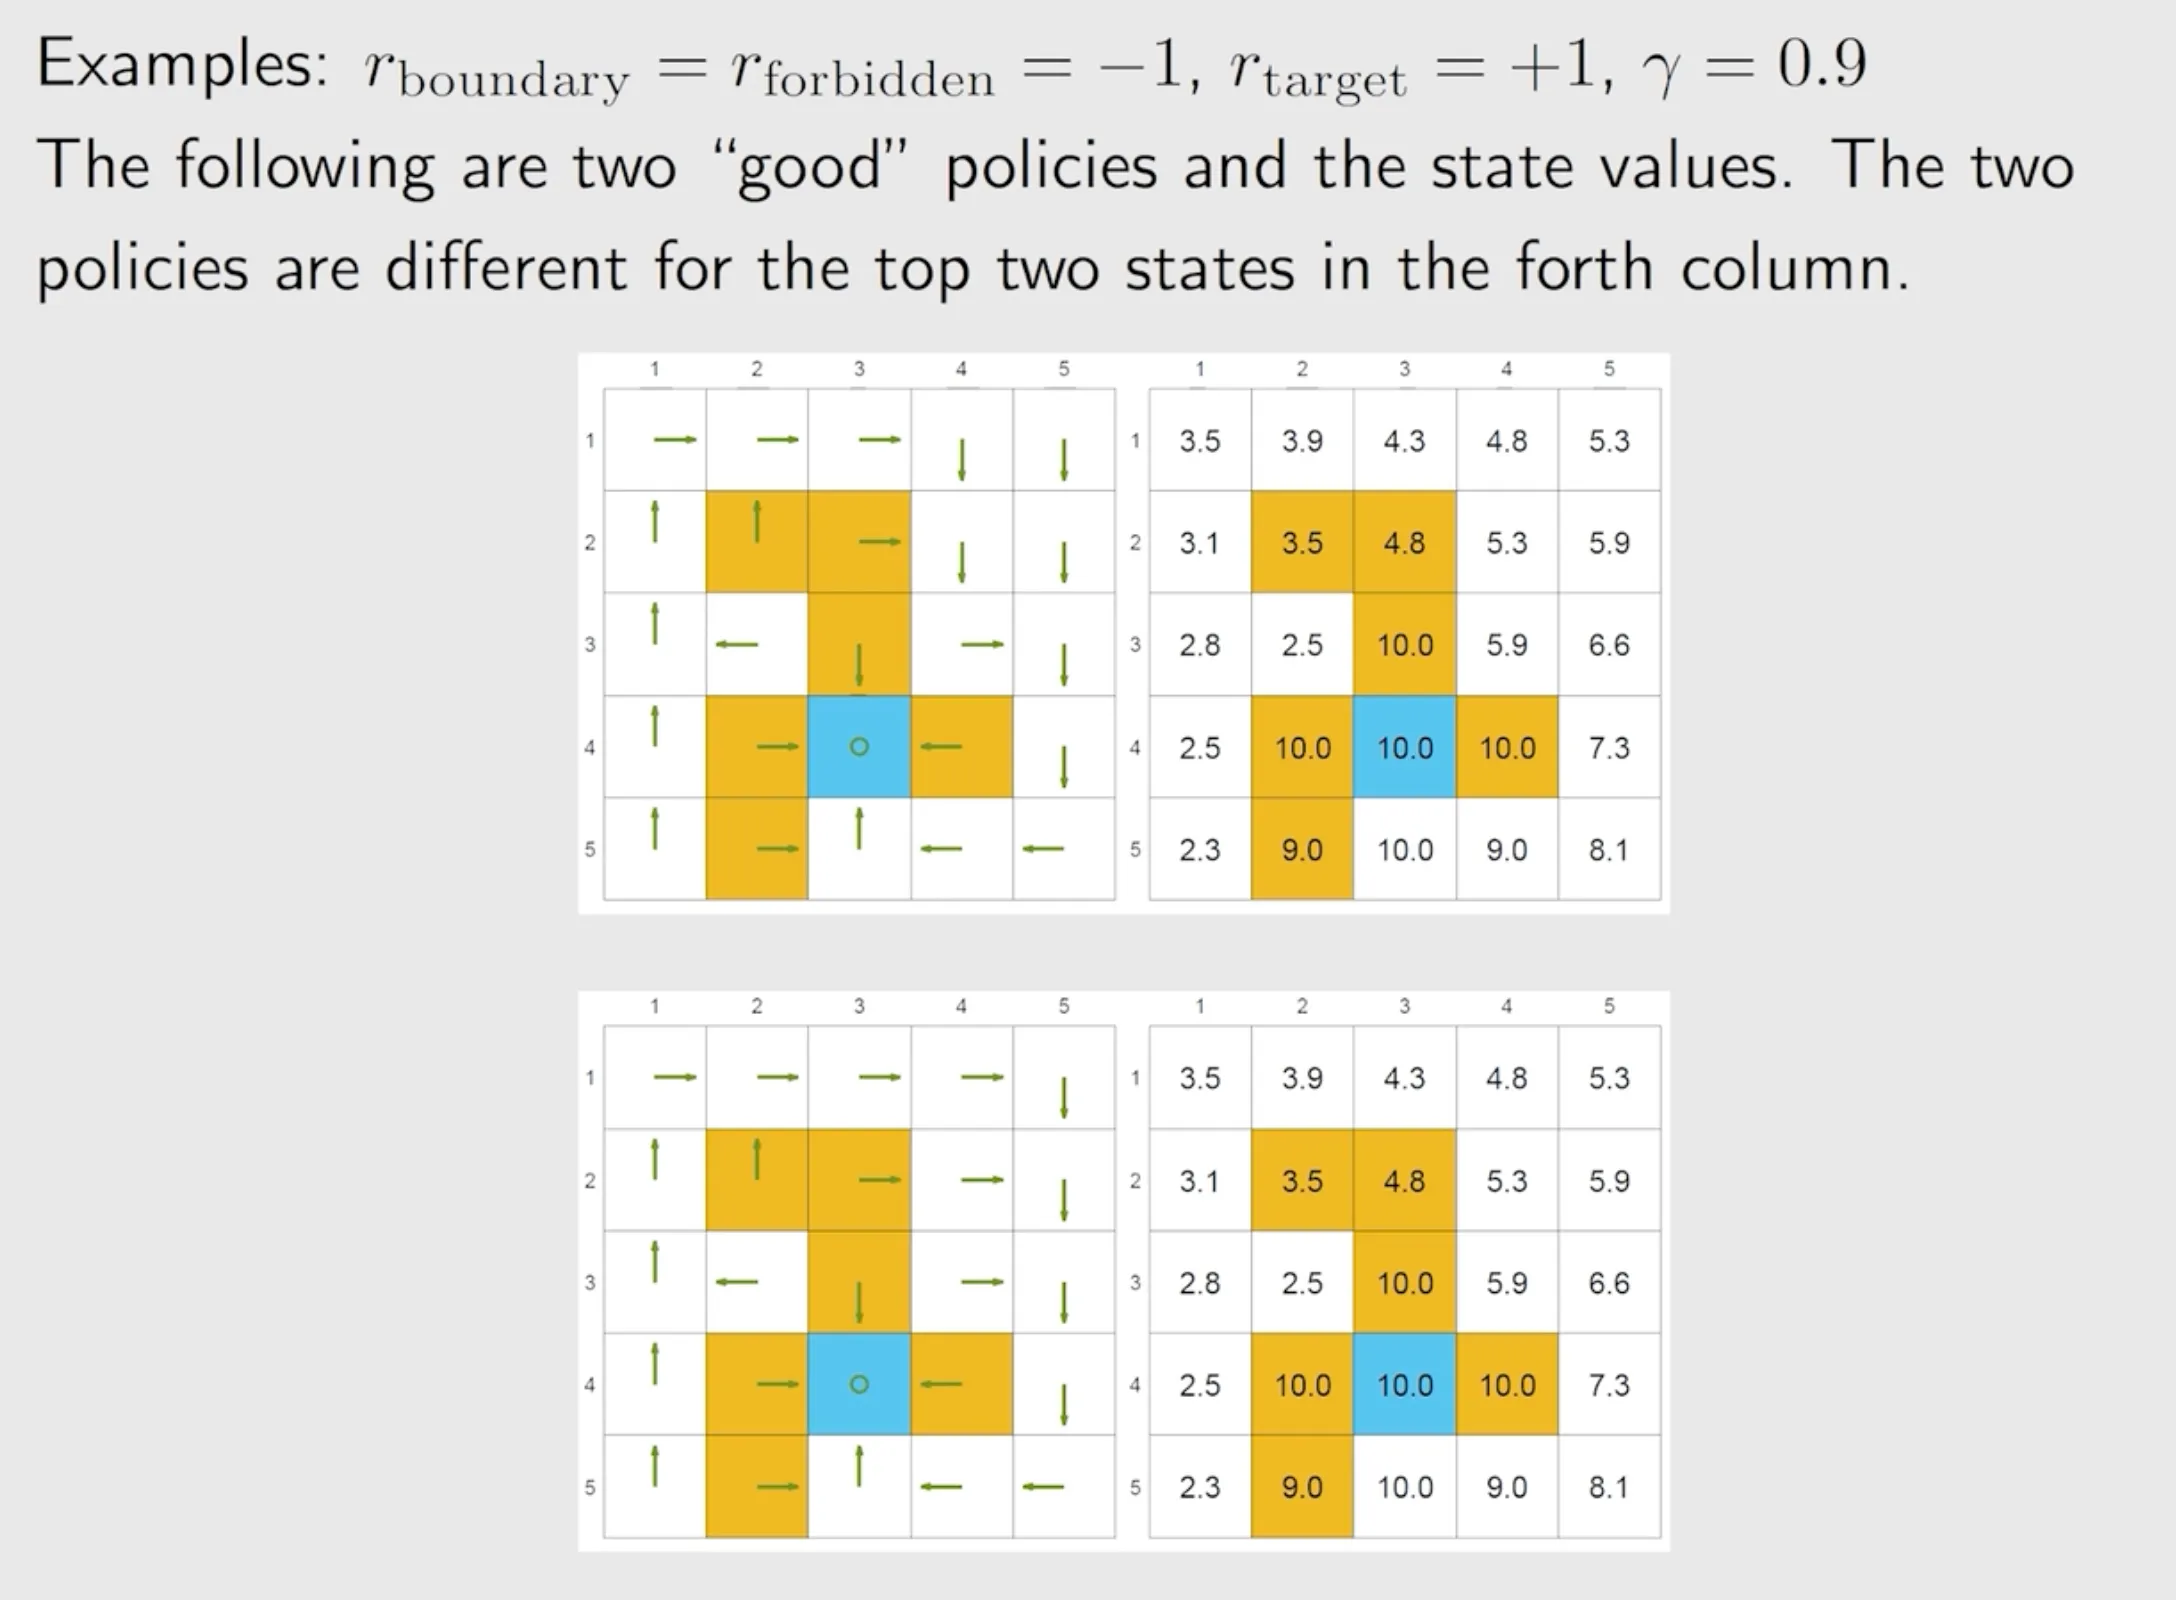
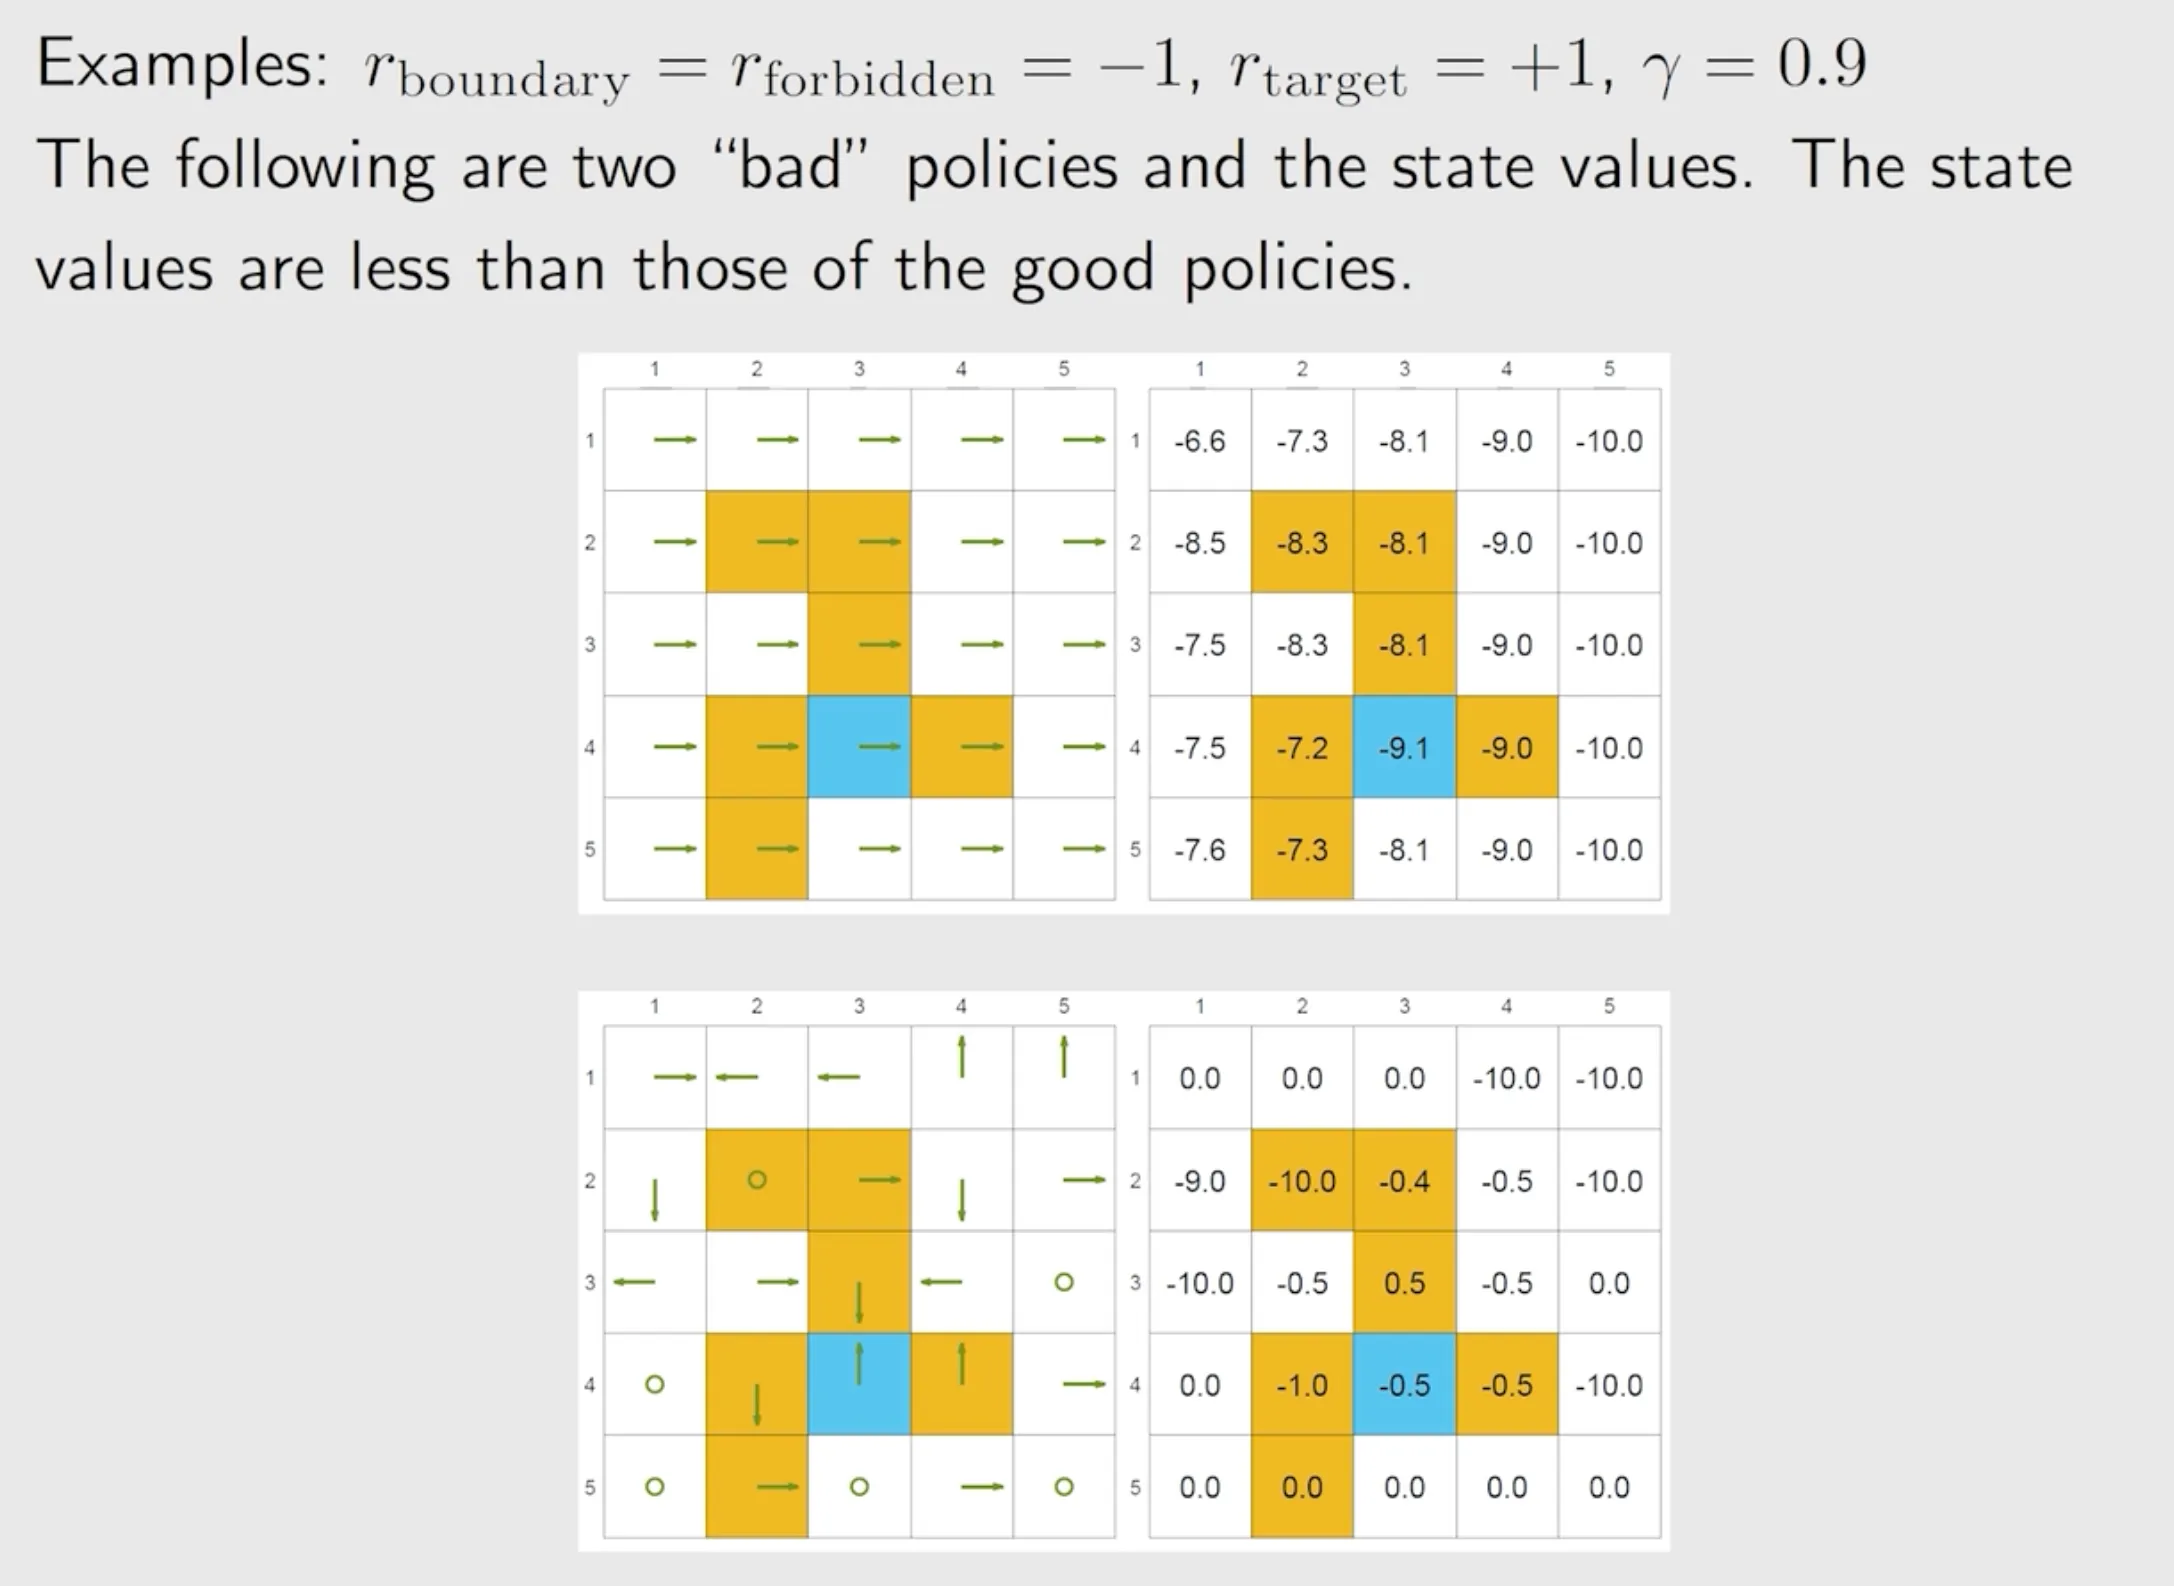
由这个例子可知,state value 可以反映一个 policy 的好坏,好的 policy 总体得分更高。
Action Value#
对比 state value 和 action value:
- state value 表示 agent 从某个 state 开始,期望可以得到的 (discounted) return.
- action value 表示 agent 从某个 state 开始并采取某个 action,期望可以得到的 (discounted) return.
action value 定义:
qπ(s,a)=E[Gt∣St=s,At=a]
state value 可以理解为对 action value 再取一次期望:
vπ(s)=E[qπ(s,a)∣St=s]
或者写成
vπ(s)=∑aπ(a∣s)qπ(s,a)
比较上式与
vπ(s)=a∑π(a∣s)[r∑p(r∣s,a)r+γs′∑p(s′∣s,a)vπ(s′)], s∈S
可得 action value 表达式为:
qπ(s,a)=r∑p(r∣s,a)r+γs′∑p(s′∣s,a)vπ(s′)
即便 policy 中没有包含某个 action,这个 action 的 action value 仍然存在。
Action Value 的计算#
有若干方法:
- 先通过 Bellman 公式算出 state value,再计算 action value
- 直接采样计算(model-free)